缓存雪崩问题
一、问题描述
描述: 缓存雪崩是指在同一时段大量的缓存key同时失效或者Redis服务宕机,导致大量请求到达数据库,带来巨大压力。
危害: 造成数据库压力骤增,甚至引发整个系统崩溃的连锁反应。
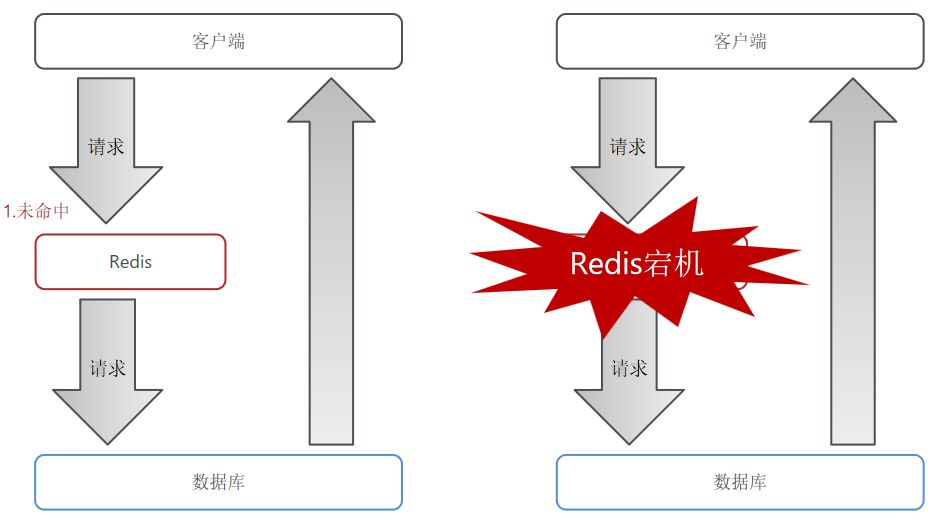
二、解决方案
1.给不同的Key的TTL添加随机值
核心思想 :防止大量缓存 Key 在同一毫秒同时失效,导致瞬间流量全部打到 DB。
做法: 在基础过期时间上增加一个离散的偏移量 。
落地示例(Java/Spring Cache 注解方式):
// 假设我们要缓存一个 User 对象
String key = "user:" + user.getId();

// 1. 固定基础时长:1小时(3600秒)
long baseTimeout = 3600L;

// 2. 随机偏移量:0 ~ 300 秒(即 0~5 分钟随机)
// 使用 ThreadLocalRandom 保证高并发下性能优于 new Random()
long randomOffset = ThreadLocalRandom.current().nextInt(300);

// 3. 最终过期时间 = 3600 + (0~299) 秒
long finalTimeout = baseTimeout + randomOffset;

// 4. 存入 Redis,并设置上述计算出的混合过期时间
redisTemplate.opsForValue().set(key, user, Duration.ofSeconds(finalTimeout));
关键点 :随机粒度不要太窄(否则还会集中),也不要太宽(避免长尾效应),通常取基础 TTL 的 5%~10% 作为随机区间。
2.利用Redis集群提高服务的可用性
-
核心目的 :防止 Redis 物理宕机 导致全盘崩溃。
-
机制 :部署主从+哨兵 (自动故障切换)或 Cluster 集群 (数据分片+冗余)。即使个别节点挂掉,集群整体依然能对外提供服务。
-
总结 :消除单点故障,从物理层面确保缓存“永不掉线”。
3.给缓存业务添加降级限流策略
-
核心目的 :当缓存彻底不可用时,保数据库不死 。
-
机制 :限流 (超出系统承受能力的请求直接拒绝) + 降级 (缓存查询失败时,返回默认兜底数据,不查询数据库)。
-
总结 :系统的最后一道“保险丝”,宁可返回旧数据或报错,也绝不让数据库被突发流量冲垮。
4.给业务添加多级缓存
-
核心目的 :在 Redis 之上再增加一道本地内存缓存 (如 Caffeine),拦截掉绝大部分重复的热点请求。
-
机制 :请求链路变为 本地缓存(纳秒级) → Redis(微秒级) → DB(毫秒级) 。本地缓存命中则直接返回,不再经过 Redis 网络 I/O。
-
总结 :用 JVM 内存挡在最前面,最大化减少对 Redis 和 DB 的穿透压力(适合读多写少场景)。
三、总结
方案** 优先级**
改造成本** 效果**
TTL 加随机值**⭐ 必做**
极低(改几行代码)
解决 90% 的周期性雪崩风险
限流降级**⭐ 必做**
中等(引入 Sentinel)
系统最核心的“保命符”,无它必死
Redis 集群**⭐ 必备**
较高(需运维配合)
消除单点故障,物理层面杜绝宕机
多级缓存** 可选**
较高(需处理缓存一致性问题)
极致性能优化,超高并发下必选